
Durante o furacão Sandy, pesquisadores analisaram o sentimento dos tuítes na trajetória da tempestade. Descobriram que a leitura isolada não capturaria esse padrão. O sentimento mudava conforme a distância do centro, quase em tempo real, permitindo estimar onde o sofrimento ocorria. Nenhum tuíte isolado tornou esse padrão visível. Somente foi possível só emergiu um entendimento quando milhares de postagens individuais foram pontuadas e mapeadas contra a localização.
Esse é o valor que a análise de sentimento agrega em escala: ela transforma um volume não administrável de texto — a maior parte não escrito para benefício de nenhum analista — em um sinal estruturado que pode realmente ser rastreado ao longo do tempo. Um único comentário ou postagem raramente diz muito a uma organização. O mesmo sinal agregado entre milhares deles, e observado enquanto sobe, desce ou se divide por tópico, conta uma história muito diferente.
Neste artigo, examinamos o que a análise de sentimento mede de fato. Examinamos os níveis de granularidade em que pode operar. Descrevemos o fluxo que transforma texto bruto em sinal utilizável e onde os resultados induzem ao erro.
O Que é Análise de Sentimento?
A análise de sentimento é a classificação de texto de acordo com a opinião que ele expressa, tipicamente como positivo, negativo ou neutro. Ela analisa a linguagem pela polaridade. Isso ocorre por meio de um dicionário fixo de termos, de um modelo estatístico treinado ou da combinação dos dois. Pode atuar em qualquer extensão, desde uma frase até um texto inteiro.
O termo se sobrepõe fortemente à mineração de opiniões (opinião mining), e na maioria dos usos cotidianos os dois são intercambiáveis. Algumas plataformas usam mineração de opiniões para se referir a uma tarefa mais direcionada. Extrair opiniões individuais vinculadas a características ou aspectos dentro de um texto é esse caso. Ainda assim, não existe linha universal, de âmbito setorial, que separe os dois termos; depende do fornecedor e do contexto.
Vale ser preciso sobre o que o resultado realmente representa. Uma pontuação de sentimento reflete a linguagem que alguém escolheu usar, não uma leitura verificada do que realmente sentiu. Frustração pode ser expressa de forma neutra, sarcasmo pode inverter completamente as palavras literais, e um tom calmo não significa necessariamente um estado mental calmo. A pontuação é uma medida de expressão, não um diagnóstico emocional.
Por Que a Análise de Sentimento Importa em Escala
O discurso público desloca-se por canais que geram muito mais texto do que a equipe consegue ler. Entre esses canais estão plataformas sociais, formulários de comentários públicos, relatórios de incidentes e fóruns abertos. O volume aumenta exatamente quando a organização precisa entender o que está sendo dito. A análise de sentimento é o que torna o rastreamento desse volume tratável, transformando-o em um número que pode ser observado ao longo do tempo, em vez de uma pilha de texto que só pode ser amostrada.
Isso importa mais durante períodos de mudança rápida. Crises aparecem, informações se espalham e narrativas mudam de forma acelerada. O sentimento tende a mover-se antes que uma única postagem revele a mudança para quem avalia mensagens. Também importa porque a desinformação não se espalha de forma uniforme. Um estudo de 2024 descobriu que apenas 0,25% das contas respondem por mais de 70% do conteúdo de baixa credibilidade. Isso indica que uma mudança súbita de sentimento vale investigar pelo que a impulsiona, não apenas rastrear como número.
Nada disso torna o sentimento um substituto para a verificação. Uma mudança negativa é um sinal de que algo vale a pena investigar, não a prova do que esse algo é. Tratar pontuações de sentimento como uma conclusão, em vez de um ponto de partida, é uma das formas mais comuns de esse tipo de análise ser mal utilizada.
Tipos e Granularidade
A análise de sentimento opera em diferentes níveis. Confundi-los tende a produzir resultados que parecem precisos, enquanto na verdade escondem o detalhe que mais importa.
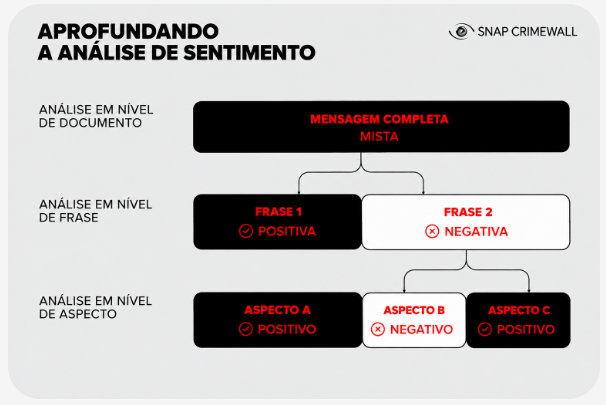
Análise em nível de documento atribui uma única pontuação de sentimento a um texto inteiro. É a abordagem mais rápida e simples, mas força um veredito único sobre conteúdo que pode conter mais de uma opinião.
Análise em nível de frase pontua cada frase dentro de um texto mais longo. Ela captura mudanças de tom que uma única pontuação em nível de documento suavizaria.
Análise em nível de aspecto vai além, identificando os tópicos ou características específicas mencionados dentro de um texto e pontuando o sentimento em relação a cada um individualmente. Este é o nível que realmente preserva uma opinião mista em vez de achatá-la em um único rótulo.
Separadamente da granularidade, os resultados da análise de sentimento variam em tipo. Há polaridade básica (positivo, negativo, neutro) e escalas mais finas com uma faixa de intensidade. Existem também tarefas adjacentes, como detecção de emoção e detecção de intenção. Nenhuma delas está em uma escada de precisão crescente. Um sistema pode combinar escopo em nível de aspecto com saída de grão fino, e nenhum substitui a necessidade do outro.
Como Funciona o Fluxo de Trabalho da Análise
Transformar texto bruto em um sinal utilizável passa por uma sequência consistente, independentemente de qual método específico faça a classificação.
Coletar e preparar os dados envolve extrair texto de fontes, como postagens sociais, formulários de comentários e relatórios de incidentes. Em seguida, limpo esse material removendo duplicatas, tratando idiomas diferentes e eliminando o que não deve ser retido por privacidade. A etapa ocorre antes de iniciar a análise.
Além disso, definir categorias e rotular uma amostra estabelece o esquema de classificação que o sistema usará, gerando a referência necessária.
Classificar e pontuar aplica o método escolhido — baseado em regras, estatístico ou um híbrido dos dois — ao conjunto completo de dados, produzindo um rótulo ou pontuação de sentimento para cada texto.
Agregar e rastrear ao longo do tempo consolida pontuações individuais em uma tendência, uma mudança ou uma comparação entre fontes, que geralmente é o nível em que o resultado realmente se torna útil a um analista, em vez de uma lista de itens pontuados individualmente.
Escalar para revisão humana envia resultados ambíguos. Resultados de alto risco ou inusitadamente confiantes voltam a uma pessoa antes que haja ação. Nenhum sistema automatizado deve ser a última verificação de uma descoberta importante.
Os Métodos por Trás da Classificação
Métodos baseados em regras e léxicos pontuam o texto contra um dicionário fixo de palavras marcadas com um valor de polaridade. São transparentes e fáceis de auditar, mas frágeis: negação, expressões idiomáticas e vocabulário desconhecido os quebram de maneiras previsíveis.
No entanto, modelos supervisionados e transformadores aprendem padrões a partir de dados rotulados, lidando com contexto e formulação melhor do que métodos léxicos. Exigem mais dados e mais manutenção, e um modelo treinado em um domínio frequentemente apresenta desempenho visivelmente pior em outro.
Abordagens híbridas combinam ambos, usando regras para casos claros e um modelo treinado para tudo o que for mais ambíguo, trocando parte da transparência de um método puramente léxico por uma precisão significativamente melhor em texto do mundo real.
Nenhum método aqui é simplesmente “melhor” no abstrato. Não devemos considerar automaticamente que um modelo maior e mais complexo seja a escolha certa quando o texto a ser analisado é curto, informal e repleto de gírias do domínio que um sistema mais simples poderia lidar tão bem quanto.
Um Exemplo Prático
Considere uma postagem pública hipotética: “As informações do abrigo foram postadas rapidamente, mas ninguém nunca confirmou quais locais ainda tinham espaço.” Um sistema em nível de documento provavelmente suavizaria isso em uma única pontuação discreta — nem claramente positiva, nem claramente negativa — e, ao fazê-lo, perderia o conteúdo real da reclamação.
Um sistema em nível de aspecto preservaria, em vez disso, ambas as metades: sentimento positivo em relação à velocidade da comunicação inicial, sentimento negativo em relação ao cumprimento do acompanhamento da capacidade dos abrigos. Essa distinção importa operacionalmente. A descoberta não é “o sentimento foi neutro”; é “a resposta inicial funcionou, mas uma etapa específica de acompanhamento não funcionou”, o que aponta para uma correção concreta, em vez de uma impressão vaga e mista.
Antes que esse tipo de descoberta seja usado, um revisor humano deve confirmar que a extração de aspectos realmente corresponde ao que o texto diz e verificar se há divergência em relação à amostra rotulada sobre a qual o sistema foi construído. Um resultado misto não é a mesma coisa que um neutro, e colapsar os dois apaga exatamente o detalhe que tornou a análise digna de ser feita.
Avaliando Resultados e Onde Eles Dão Errado
Construir um conjunto de testes rotulado genuinamente útil significa incluir casos ambíguos e divergências, não apenas os exemplos claros que são mais fáceis de rotular, já que um conjunto de testes feitos inteiramente de casos óbvios não revelará como o sistema lida com algo difícil.
Ler precisão, recall e macro-F1 em vez de acurácia bruta importa mais quando uma categoria de sentimento domina o conjunto de dados. Um sistema que prevê sempre a classe majoritária pode apresentar alta acurácia, mas falha completamente em todas as categorias minoritárias — exatamente o que o macro-F1 captura.
Sarcasmo e negação permanecem um ponto fraco genuíno. O sarcasmo sozinho já demonstrou representar uma queda de até 50% na precisão da classificação, e a negação — uma palavra como “nunca” ou “nada” aparecendo perto de uma frase de outra forma positiva — causa falhas igualmente previsíveis em sistemas mais simples.
Confundir texto neutro com opinião genuinamente mista colapsa duas situações muito diferentes em um único rótulo. Uma declaração factual sem opinião vinculada e uma declaração contendo elogios e críticas podem ambas pontuar como “neutras” sob um esquema grosseiro, embora signifiquem coisas completamente diferentes.
Mudança de domínio e deriva ao longo do tempo significam que um sistema treinado em um tipo de texto, ou um período, pode silenciosamente degradar em precisão conforme a linguagem, os tópicos ou o contexto mudam, sem que ninguém perceba até que o resultado pareça fazer sentido.
Uma pontuação de confiança alta não é o mesmo que sentimento forte. A confiança reflete o quão certo um modelo está sobre sua própria classificação, não quão intensamente positivo ou negativo o texto subjacente realmente é, e tratar os dois como equivalentes leva a conclusões excessivamente confiantes.
Escolhendo uma Abordagem de Análise de Sentimento
A abordagem certa depende das fontes envolvidas e do fluxo de trabalho em que precisa se encaixar, não de qual método soa mais sofisticado. Algumas perguntas valem a pena ser respondidas antes de se comprometer com uma: ela cobre as fontes reais sendo monitoradas? Ela produz detalhes em nível de aspecto sobre conteúdo genuinamente misto, em vez de achatar tudo em uma única pontuação? Ela apresenta desempenho consistente em todos os idiomas e dialetos realmente usados, não apenas no idioma avaliado pelo benchmark.
Também é essencial que possamos inspecionar os erros de fato. Um sistema que não consegue exportar seus rótulos, mostrar seu raciocínio ou permitir correção quando erra algo é difícil de confiar com qualquer coisa que importe. Executar um piloto pequeno e representativo em dados reais, em vez de confiar em um benchmark publicado por um fornecedor, geralmente é a maneira mais rápida de descobrir se uma determinada abordagem realmente se sustenta no texto que uma organização lida no dia a dia.
A Mensagem Principal
A análise de sentimento funciona ao transformar volumes de texto difíceis de administrar em dados que podem ser rastreados, comparados e observados quanto às mudanças ao longo do tempo. Mas o resultado é uma medida de linguagem, não um relato verificado do que alguém realmente sentiu, e tratar uma pontuação de sentimento como uma conclusão, em vez de uma pista, é onde esse tipo de análise mais frequentemente dá errado.
O uso mais forte da análise de sentimento emparelha o nível certo de granularidade com um método adequado ao texto em questão e, então, encaminha tudo o que for ambíguo ou de alto risco a uma pessoa antes que molde uma decisão. Uma mudança de sentimento é uma razão para olhar mais de perto, não uma resposta por si só.
Perguntas Frequentes (FAQ)
Mineração de opiniões é o mesmo que análise de sentimento?
No entanto, na maioria dos contextos, os termos são usados de forma intercambiável. Alguns fornecedores usam mineração de opiniões especificamente para extração em nível de aspecto — extraindo o sentimento em relação a características individuais dentro de um texto — mas não existe um padrão setorial universal que separe os dois termos.
Qual é a diferença entre análise em nível de documento, frase e aspecto?
A análise em nível de documento atribui uma pontuação a um texto inteiro. A análise em nível de frase pontua cada frase separadamente. O nível de análise em aspecto identifica tópicos específicos dentro de um texto e pontua o sentimento em relação a cada um individualmente — é o único nível que preserva uma opinião genuinamente mista.
Como o sentimento é diferente de emoção ou intenção?
O sentimento mede a polaridade — se a linguagem é positiva, negativa ou neutra. A detecção de emoção e a detecção de intenção identificam sentimentos específicos ou objetivos subjacentes no texto, e o sistema pode suportar uma delas sem a outra.
Um modelo consegue detectar sarcasmo e feedback misto de forma confiável?
Não de forma consistente. Além disso, o sarcasmo isolado reduz a precisão em até 50% em alguns sistemas.
Como uma equipe deve medir a qualidade da análise de sentimento?
Rastreando precisão, recall e macro-F1 em vez de acurácia bruta, especialmente quando uma categoria de sentimento domina o conjunto de dados, e testando em uma amostra rotulada que inclua casos ambíguos e comuns, não apenas os exemplos mais claros.
